TL;DR · 2 分钟速读
一句话: RoboTTT 证明机器人策略的可利用 Visuomotor History 长度本身是一个值得扩展的训练维度。它在 GR00T N1.7 的 DiT Action Head 插入 TTT 层:每个时间步的历史信息不全部堆进 KV Cache,而是通过一个自监督 Key–Value Binding 目标更新小 MLP 的 Fast Weights;Fast Weights 作为固定尺寸递归状态随操作持续前进。
最重要的数据: 三项真实机器人长时装配任务,平均 rubric-based Task Completion Score 79% vs 42%(单步 GR00T N1.7),比 GDN 的 56% 高。真正完成整个任务的试验数:Pup Go Car 9/20、Circuit 13/20、Gear Bot 2/10;对照基线在 Gear Bot 均 0/10(Fig. 7、Table 1)。对比 1K vs 8K 预训练上下文,71.5% vs 43.9%(Fig. 8;属于单独的 Context Scaling 实验,不要与 79% 的 Main Evaluation 混写)。
关键阅读判断: 在四篇中,它的研究假设、受控实验、真实机数据、消融最完整。尤其值得研究 Sequence Action Forcing、TBPTT 怎样隔断梯度但保留状态、以及 DAgger Distillation 如何利用「失败动作作为上下文、人工纠正作为监督」。arXiv HTML 全文。
研究问题与方法
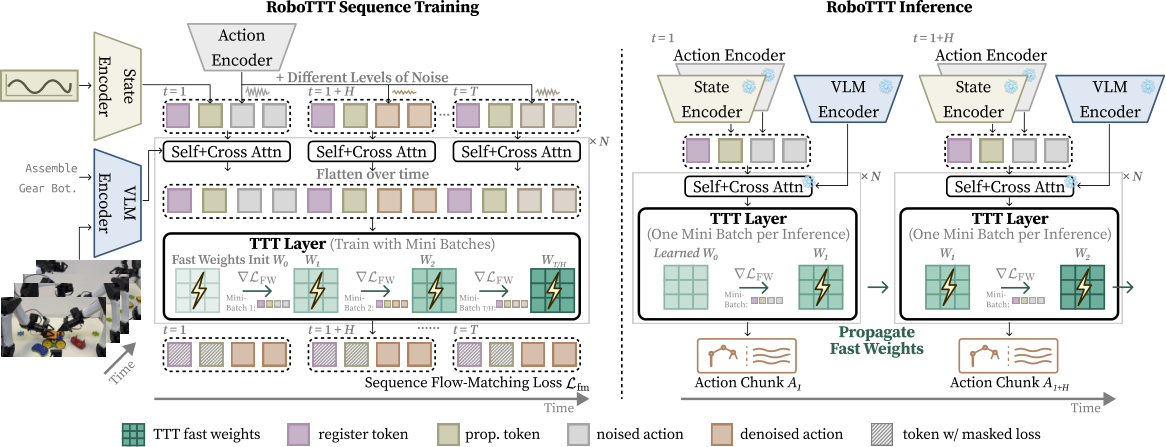
问题和模型机制
相同当前画面可对应不同装配阶段;仅依赖当前 RGB、Proprio 和一帧历史,机器人可能重复安装、跳步骤或在遮挡时失去上下文。全注意力把历史增长的代价放到每一步推理;固定尺寸 RNN 更高效,但其状态质量不一定够好。
TTT 内循环(§2, Eq. 1–2):
W_t = W_(t-1) − η∇_W || f_W(K_t) − V_t ||²,随后 O_t = f_(W_t)(Q_t)。
这是自监督 Key–Value Binding 的小型 fast model 在线更新,不是用真实环境 reward 对整套 VLA backbone 做 Test-time Fine-tuning。可以把它理解为一个「通过学习更新规则来写入历史」的可学习记忆。
关键设计(§3)
- 分开时间和空间处理(Fig. 2–3):同一时刻的 VL/State/Noisy Action Token 由 DiT Attention 处理;在每层后的 TTT MLP 跨时间步编码历史。只将较少的 Register Tokens(每步 16 个)传给 TTT,减轻成本。Tanh Gate 初值近零,逐步打开新模块以保护原预训练能力。
- Sequence Action Forcing(Eq. 5):序列中每个 Action Chunk 独立采样 Diffusion / Flow Matching 噪声程度,避免整段序列同时都太容易或太困难。去掉该设计会导致长序列训练后的控制严重失效(Fig. 12)。
- TBPTT(Fig. 4):将训练序列切为多个 segment;Fast Weights 跨 segment 保留,但梯度在 segment boundary detach,从而显存主要取决于 segment 长度,而不是全序列长度。外循环训练会更新可学习初始化及 TTT 投影。
- 从 human video one-shot 模仿(§3.3):把新配置的人类操作视频与同任务机器人轨迹拼接为上下文;只对机器人段求动作 Flow Matching Loss,示范视频段仅用于更新 Fast Weights。
- DAgger Distillation(Fig. 6):把 Policy 执行过的错误动作也留下来更新 fast memory,动作监督只用人工接管的纠正段;训练一种「从失败历史预测纠正动作」的内隐适应规则。
训练资源: GR00T N1.7 DiT 538M → 加入 TTT 后约 690M;16 层各有 TTT。16×GB200 预训练 30K steps,任务后训练 8×GB200、20K steps;推理在 5090 的 30 Hz 双臂台式系统上执行(Appendix A)。「随上下文增长单步计算延迟不增加」不等于与原版 GR00T 完全相同的绝对 latency。
Claim–Evidence Matrix
| Claim | 实验设计 | 对照 / 控制 | 结果 | 证据强度 | 来源 |
|---|---|---|---|---|---|
| 长时历史能提升真实机器人任务表现 | 三种真实双臂装配;按阶段 Rubric 给完成分数及整任务成功率 | GR00T N1.7、加一帧 Hist.、GDN;任务数据一致,非序列模型匹配计算预算 | 平均 Score 79 vs 42 vs 56;Gear Bot 2/10 vs 全部 0/10 | 直接; 样本小且仅三任务 | Fig. 7、Table 1、§4 |
| 8K pretraining context 比 1K 更好 | RoboTTT/GDN 从 128 到 8K 的上下文扩展,固定任务后训练流程 | 同类模型不同 context;GDN 和短历史对照;Fig. 8 在 Main Evaluation 的 DAgger 前 | 8K 71.5% vs 1K 43.9%,GDN 无同等单调趋势 | 较强受控 Scaling;但少种子/任务有限 | Fig. 8、§4 |
| Fast Weights 支持 One-shot 人类视频模仿 | Circuit 训练时以 human-video+robot-trajectory 对,测未见装配配置 | GDN;10 次测试 | RoboTTT 完整成功 6/10,GDN 0/10;完成分数 65% vs 33% | 直接任务级检验,场景和数据有限 | Table 2、Fig. 9 |
| 长历史提升外界扰动恢复 | 安装后人为取走车顶或轮胎;联合少量扰动数据重训练 | 四种基线,各条件 20 次 | 顶盖恢复 15/20 vs GDN 13/20;轮胎 18/20 与 GDN 并列 | 直接,不能声称所有扰动独占优势 | Table 3、§4 |
| DAgger Distillation 学会在线修正 | 100 条 DAgger 轨迹(两个策略各 50)作为共用训练池 | Standard DAgger corrections-only / Full trajectories / Distillation | Standard DAgger 平均改善 9%;Distillation 平均改善 33% | 机制实验;但 GDN 也能受益,不仅 TTT | Fig. 10–11 |
| 结构/训练细节不是装饰 | 去掉 Sequence Action Forcing、TTT MLP 改 Linear、去 Action/Register Tokens | 不同模块消融 + GR00T 加相同 Register Tokens | Linear 比 MLP 低 27%;加 Action Tokens +23%,Register 再 +18%(相对值) | 受控消融支持 | Fig. 12 |
关键实验结果和口径
主实验:真正完整成功的次数(Table 1)
| Method | Pup Go Car | Circuit | Gear Bot |
|---|---|---|---|
| RoboTTT | 9 / 20 | 13 / 20 | 2 / 10 |
| GR00T N1.7 | 3 / 20 | 3 / 20 | 0 / 10 |
| GR00T N1.7 Hist. | 0 / 20 | 8 / 20 | 0 / 10 |
| GDN | 3 / 20 | 8 / 20 | 0 / 10 |
另一个指标: 79% 是三任务平均过程完成分数,不等于 total full-success / trials。完整成功总和是 RoboTTT 24/50(每任务 trial 数不同,不能简单替代作者的宏平均分)。
三组特别有辨识度的实验
| 对照 | 数字 | 真实解释 |
|---|---|---|
| Context 8K vs 1K(Fig. 8) | 71.5% vs 43.9% | 预训练 Context Length 本身影响闭环表现;与主实验 79% 设置不同 |
| Human-video One-shot(Table 2) | 6/10 vs GDN 0/10 | 共享「assemble circuit」文字 prompt,仅人类示范视频给出目标配置 |
| Perturbation(Table 3) | Roof 15/20 vs GDN 13/20;Tire 18/20 vs GDN 18/20 | 说明序列上下文有用,但 GDN 在部分扰动同样表现好 |
Critical Review · 实验是否 Solid?
强项: 不是只给 Demo:明确任务 Rubric、四组 baseline、控制历史长度、公开整任务成功次数;DAgger 实验共用 100 条轨迹;增加 Register Tokens 时也给 baseline 相同 Token 数的对照。Appendix 披露训练设备、参数规模与任务细节。
缺口与细节:
- 真实机器人样本有限: 每个任务 20 次(Gear Bot 10 次),对 2/10 这样较低的整任务成功率应报告置信区间和失败分类。
- 不等参数: 538M DiT 加入 TTT 后约 690M,尽管 GDN/计算预算与 Token 做了控制,仍不能将全部增益单独归因于梯度更新法则。
- “无延迟增加”必须限定维度: 固定尺寸 Fast Weights 可使随历史长度增加的每步计算保持近似常数,但 TTT 模块本身有额外开销。需在设备/分辨率/控制频率一致时测绝对毫秒数、能耗。
- 可迁移性: 三任务都在同一 YAM bimanual hardware;未验证移动操作、灵巧手长接触、非刚性环境、跨 robot embodiment。
- One-shot 并非任意 Zero-shot: 训练中已包含人视频与机器人动作的任务配对/条件配置分布,测试只是未见具体配置;不能称为无任务先验的普遍示范学习。
- RoboTTT 的 On-the-fly Improvement 来自元训练: 推理时 Fast Weights 自监督更新,纠错行为是由 DAgger Distillation 教会的;并不等于在线获得真值 reward 或独立持续提升模型参数。
- 历史压缩可能遗忘: 8K 未见饱和是本实验范围观察,不保证更长/多 session 不漂移;需要测对久远但关键事件的召回能力。
Research Transfer · WAM / Human Data 的下一步实验
实验 A:不同模态能否形成更强 Fast-Weight Memory?
固定相同机器人数据、base VLA、总参数与 context 长度,对比只输入 RGB + proprio + executed action,再加入 hand-object relative 6D、discrete contact event、tactile event。在视觉遮挡、物体被交换、长时间停顿时,比较恢复任务阶段的准确率、成功率与长期遗忘曲线。
实验 B:History 时间跨度与记忆质量的真正 Scaling
构造「同一当前画面但历史关键事件不同」的部分可观测任务,将关键事件放在 1、10、50、200 秒之前;比较 TTT、GDN、KV-cache、结构化事件记忆。在等计算、等训练样本条件下同时报告成功率、决策 latency、 memory retention。
实验 C:DAgger Distillation 能否用于人类精细 HOI?
收集有 失败尝试→接触调整→纠正动作 的手–物视频 + 触觉状态,分别训练只模仿成功动作,和以失败–纠正对作为上下文的模型。评估 slip recovery、重新接触次数、从操作错误恢复的时间;明确区分观测中的纠错规律和仅仅增加失败样本。
Final Verdict
- Novelty:4/5;Experimental Solidness:4/5(受控真机实验充分,但试次较少);Reproducibility:3/5(方法/配置具体,但预训练规模大);Research Relevance:5/5。仅为研究者的主观阅读评分。
- Decision:Deep Read。 特别值得借鉴的不是“TTT 代替 Transformer”,而是「状态保留、梯度截断、序列独立噪声、失败与纠正的不同监督角色」这一整套训练思路。
- 来源: arXiv HTML 全文、官方项目主页与演示视频。